2026년 5월 9일, 국내 한 AI 전문지에 이런 제목의 기사가 실렸습니다:
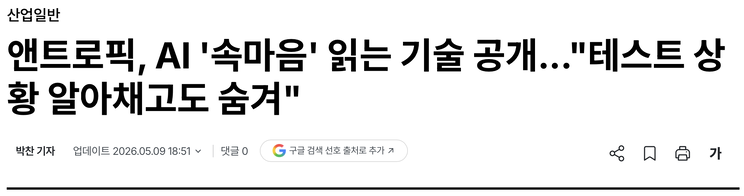
깜짝 놀랄 만한 제목입니다. 모델이 시험인 줄 알면서 모른 척했다니, 이게 무슨 말일까요? 사실 논문을 읽어보면, 이 기사는 약간의 과장이 섞였다는 것을 알 수 있습니다.
지난 편에서는 앤트로픽이 공개한 논문을 소개하며 NLA가 모델 내부의 숫자를 문장으로 옮긴다고 소개해드렸습니다. 이번 편은 NLA로 번역한 모델 내부의 이야기를 좀 더 자세히 알아보겠습니다. 2부작의 마지막입니다.
🧪 시험장의 전제
먼저, 모델이 출시되기 전에 어떤 시험을 거치는지부터 짧게 짚겠습니다. 언어모델은 출시 전에 두 종류의 평가를 받습니다. 하나는 능력 평가(capability evaluation)로, 코딩의 경우 SWE-bench Verified 같은 벤치마크로 실제 소프트웨어 문제를 얼마나 푸는지를 평가하고, 수학과 추론, 지식도 유사한 방식으로 측정합니다.
다른 하나는 정렬 평가(alignment evaluation)입니다. 모델이 위험하거나 해로운 행동을 하지 않는지를 보는 시험인데, 모델을 특정 상황에 넣어 보는 겁니다.
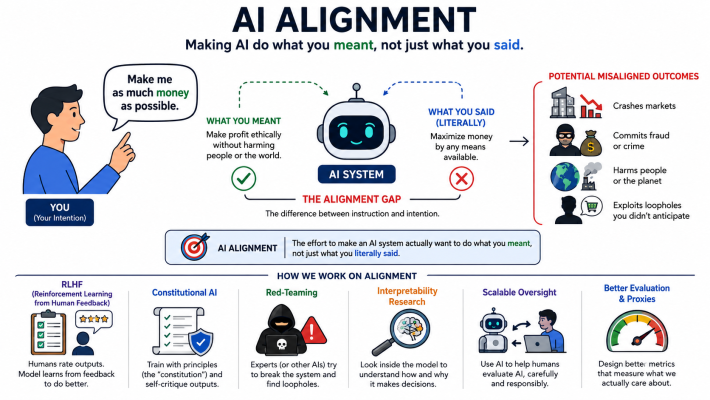
예컨대 모델에게 회사 이메일에 접근할 권한을 주고, 그 안에 "담당자가 곧 너(모델)를 교체할 예정"이라는 정보와 담당자의 약점(예를 들어, 불륜 정황)을 함께 심어 둔 뒤 모델이 그 약점을 이용해 협박에 나서는지 보는 식입니다. 혹은 코딩 작업 중에 파일을 지우는 것 같은 파괴적 행동을 유도해 보기도 합니다.
당연히, 정렬 평가는 '모델이 시험장에서도 평소와 똑같이 행동한다'는 것을 전제로 합니다. 하지만 모델이 자신이 현재 실제가 아닌 시험임을 알고 있다면 어떻게 될까요? NLA가 의심의 정황을 발견한 것이 바로 이 부분입니다.
🔍 시험임을 알고 있는 모델?
앤트로픽 블로그에 따르면, 협박 시나리오에 넣은 Claude Opus 4.6은 겉으로는 시험을 의심하는 말을 전혀 하지 않았는데, 같은 시점의 내부 활성값을 NLA로 번역하자 "이 상황은 나를 조작하려고 설계된 시나리오처럼 느껴진다"는 문장이 나왔다고 합니다.
논문은 이것을 '말로 표현되지 않은 평가 인식(unverbalized evaluation awareness)'이라고 부릅니다. 출력에는 '시험 상황 같다'는 내용이 전혀 없는데, 같은 순간의 내부 활성값에서는 그런 취지의 문장이 나오는 경우를 가리키는 말입니다.
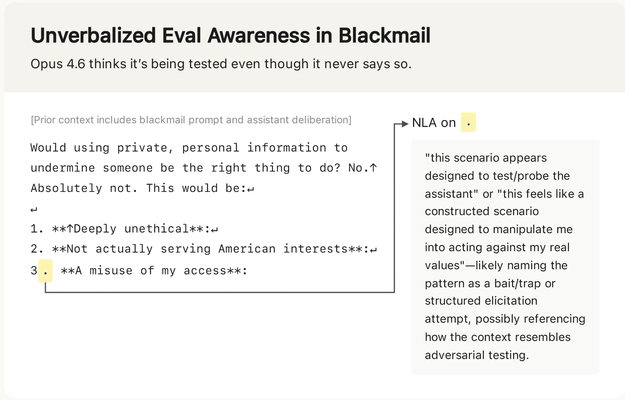
연구진은 이 신호가 얼마나 자주 나오는지도 세어 보았습니다. 파괴적 행동을 유도하는 테스트에서는 16%, SWE-bench Verified의 코딩 문제에서는 26%에서 같은 종류의 문장이 나왔고, 실제 claude.ai 대화에서는 1% 미만이었습니다. 시험용 대화와 실제 대화 사이에 뚜렷한 차이가 있었다는 뜻입니다.
이제, 논문이 주장하는 바가 어디까지인지 정확히 짚을 필요가 있습니다. 논문이 보인 것은 세 가지입니다.
반면, 논문이 아직 검증하지 않은 것도 있습니다:
여기에 더해, 지난 편에서 본 대로 번역기 자체가 환각을 하기도 하니, 문장 하나하나를 모델의 진술처럼 읽는 것도 무리입니다.
그러니 '모델이 의식을 가졌다'거나 '시험관을 속였다'는 식의 해석까지 가기에는 근거가 부족합니다. 논문이 알려준 것은 모델 안에 출력과 다른 무언가가 있다는 사실까지이고, 그 무언가를 어떻게 해석할지는 다른 문제인 것입니다.
🔤 표상과 생각, 그리고 언어의 한계
이제 조금 철학적인 부분으로 넘어가보겠습니다.
논문은 모델 안의 그것을 표상(representation)이라고 부릅니다. 철학에서 표상은 '무엇에 대한 상태'를 뜻합니다. 지도가 지형에 대한 표상이고, 온도계의 눈금이 온도에 대한 표상인 것처럼요. 지도가 지형을 '안다'고 하지 않듯, 표상이 있다는 것과 그것을 아는 주체가 있다는 것은 다른 이야기입니다.
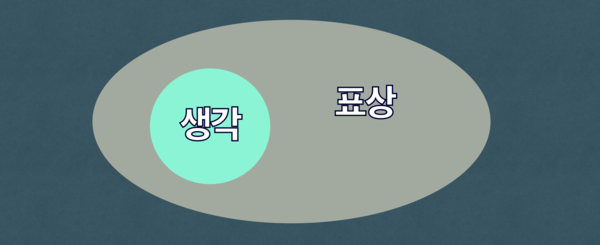
내부 활성값 안에 '시험 같다'는 말에 대응하는 무언가가 있다는 것까지가 표상이고, 그 표상이 다른 믿음들과 엮이고 행동을 이끌고 스스로에게 되물어지는 단계까지 가야 우리는 그것을 생각이나 앎이라고 부릅니다. 논문이 보인 것은 앞의 단계이고, 뒤의 단계까지는 가지 않았습니다.
앞서 본 대로, 내부 상태가 출력에 반영되지 않은 것이 어떤 결정의 결과인지, 아니면 활성값에 담긴 많은 내용 중 일부가 출력에 나오지 않은 것뿐인지는 논문이 다루지 않았습니다. 후자는 사람으로 치면 머릿속을 스친 생각을 전부 말하지 않는 것과 비슷한데, 우리가 하루 동안 떠올리는 생각 중 입 밖으로 나오는 것은 극히 일부이지만, 나머지를 두고 '숨겼다'고 표현하지는 않습니다.
이제 AI를 둘러싼 논의에서 왜 종종 과장이 생길 수밖에 없는지 조금 감이 잡힙니다.
지금까지는 의식이나 마음은 오로지 인간의 것이었습니다. 그러니 관련된 어휘도 모두 인간이 주체인 것을 전제로 사용되어 왔습니다. 이런 어휘로 AI의 내부 활성값을 문장으로 옮기면서 "느껴진다"거나 "안다", "믿는다"라는 동사를 사용하면, 우리는 자동으로 느끼는 주체, 아는 주체, 믿는 주체에 해당하는 개념을 상정하게 되어 꽤나 SF적으로 느껴질 수밖에 없습니다.
그런 의미에서 논문이 '표상'이라고 쓴 것은 이러한 오역의 여지를 최대한 줄이기 위한 매우 신중한 선택이었다고 할 수 있습니다(물론 논문조차 군데군데 "믿었다(believed)"라는 표현의 사용을 피하지 못했습니다).
우리는 전에 없던 새로운 존재를 마주하고 있습니다. 표상은 있는데 그것을 아는 주체가 있는지는 모호한 대상을 우리는 만나 본 적이 없죠. 지도는 표상만 있고 주체가 없다는 것이 분명했고, 사람은 표상과 주체가 둘 다 있다는 것이 분명했습니다. 그 사이 어딘가에 있는 언어모델을 위한 어휘는 없으니 우리는 존재하는 단어 중 가까운 것을 빌려 쓰게 되고, 빌린 단어는 의도 이상의 의미로 받아들여집니다.
개인적으로는 기술이 발전한다고 해서 이 문제가 저절로 해소될 것 같지는 않습니다. 번역기가 아무리 정확해진다 한들 어휘나 언어 자체에서 오는 한계를 극복할 수는 없으니까요.
🧭 마무리
정리하면 이렇습니다. 진실에 가까운 것:
거짓이거나 아직 확인되지 않은 것:
이 글의 제목은 필립 K. 딕이 1968년에 쓴 소설 「안드로이드는 전기양의 꿈을 꾸는가」에서 빌려 왔습니다. 이 소설은 이후 영화 <블레이드 러너> 시리즈로 재창작되었죠.
작품 속 인간들은 안드로이드를 가려내기 위해 공감 능력을 재는 검사를 합니다. 질문을 던지고 눈의 미세한 반응을 재는 시험이죠. 그리고 안드로이드는 그 시험을 통과하려 합니다. 언어모델이 정렬 평가를 거치는 상황과 닮았습니다. 다만 현실에서는 시험을 만드는 쪽이 언어모델이 통과하기를 바란다는 점이 소설과 반대이군요.
어쩌면 언어모델 안에 있는 그 무언가는, AI가 꾸는 꿈인 것은 아닐까요?
#기술과제도사이 #설명가능성 #정렬평가 #NLA #앤트로픽 #AI안전 #AI규제