지난 글에서는 독일 법원 사례를 알아보았습니다. 그렇다면 AI 기업들의 본거지인 미국은 어떨까요.
결론부터 말하면, 미국 법원들은 독일 법원과 판단을 달리합니다. AI 학습은 공정이용에 가깝다는 쪽이죠. 다만 AI 학습을 둘러싼 다툼의 상당수가 판결이 아니라 거액의 합의로 덮이고 있다는 점이 주목할만 합니다.
이 글에서는 AI 학습을 둘러싼 미국의 메이저 사건 세 개를 알아보겠습니다.
⚖️ 공정이용이라는 저울
먼저 미국 저작권법의 공정이용(Fair Use)을 짚고 가겠습니다. 남의 저작물을 허락 없이 써도 되는 예외인데, 법원은 아래 네 가지 요소를 두고 판단합니다.
이 중 AI 학습 사건에서 쟁점이 되는 것은 사실상 첫 번째와 네 번째입니다. AI가 책을 읽고 언어의 패턴을 익히는 것을 원작을 대체하는 일로 볼 것인지 혹은 전혀 다른 무언가로 바꾸는 일로 볼 것인지(변형성), 그리고 그 결과가 원작의 시장을 잠식하는지(시장 영향)를 판단하는 것이죠.
저작물의 존재 여부가 아니라 이용의 성격과 결과를 따지는 것이니, 지난 글에서 본 독일 법원이 '저작물이 AI 모델 안에 남아 있느냐'와는 출발점 자체가 다른 다툼인 것입니다.
📕 첫 번째 - 톰슨로이터 v. 로스 인텔리전스[1]: 공정이용이 배척된 첫 사례
사건의 발단은 라이선스 거절이었습니다. 법률 AI 스타트업 로스 인텔리전스는 판례 검색 서비스를 만들면서 톰슨 로이터에서 제공하는 리걸 리서치 서비스 웨스트로(Westlaw)의 데이터를 쓰고 싶어 했지만, 경쟁사가 될 것을 우려한 톰슨로이터가 거절했습니다.
그러자 로스 인텔리전스는 우회로를 택했습니다. 외부 업체에 의뢰해 '법률 메모' 묶음을 만들게 했는데, 그 메모들이 사실상 웨스트로의 판례 요약(헤드노트)을 바탕으로 작성된 것이었습니다.
우선, 법원은 헤드노트가 단순한 판결문 발췌가 아니라 편집자의 판단이 들어간 창작물이라고 보았고, 이를 학습에 사용한 행위에 공정이용을 인정하지 않았습니다.
이 사건에서 가장 큰 쟁점은 네 번째 요소(시장 영향)습니다. 법원은 로스 인텔리전스가 만들려던 것이 결국 웨스트로와 직접 경쟁하는 대체재였다는 점, 그리고 톰슨 로이터가 'AI 학습용 데이터를 라이선스할 수 있었던 잠재적 시장'까지 침해됐다는 점을 짚었습니다. 이 중 후자의 경우, 법원이 '학습 데이터 라이선스 시장'이라는 것의 존재를 인정한 셈이므로 특히 중요한 지점입니다.
다만 이 사건에는 큰 단서가 붙습니다. 로스 인텔리전스의 AI는 생성형이 아니라 검색형이었고, 재판부도 자신의 판단이 생성형 AI에까지 그대로 적용되는 것은 아니라고 밝혔습니다.
[1] Thomson Reuters v. Ross Intelligence — 미국 델라웨어지방법원, 2025년 2월 판결. 로스가 중간항소를 신청해 제3순회항소법원이 2025년 6월 이를 받아들였고, 2026년 6월 11일 구두변론이 열렸다(사건번호 25-2153). 판결은 아직 선고되지 않았다.
참고로 현재 로스 인텔리전스는 소송 비용을 감당하지 못하고 이미 사업을 접은 상태입니다.
📗 두 번째 - 바츠 v. 앤트로픽[2]: 학습은 되고, 해적판은 안 된다
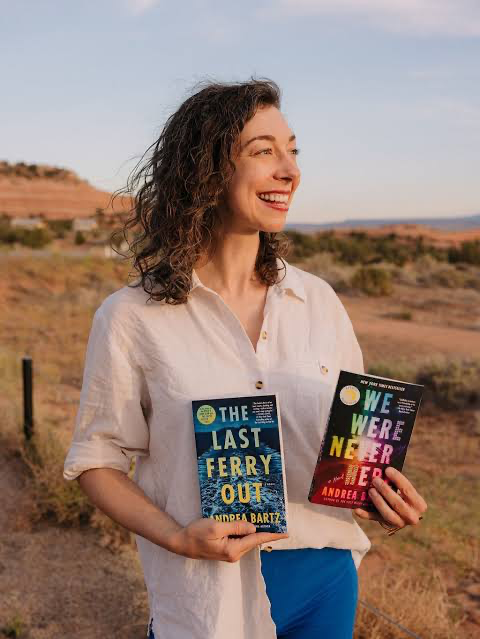
이 사건은 스릴러 작가 안드레아 바츠 외 2명의 작가들이 2024년 8월 앤트로픽을 상대로 낸 소송입니다. 이들의 주장은 앤트로픽이 리브젠(LibGen) 같은 이른바 '섀도 라이브러리'에서 저작권 있는 책을 대량으로 내려받아 클로드의 학습에 썼고, 그렇게 모은 책들을 학습에 쓰지 않기로 한 뒤에도 사내 도서관에 영구 보관했다는 것이었습니다.
이 사건을 담당한 앨섭 판사는 앤트로픽의 행위를 세 갈래로 나눠 판단했는데, 이 분해가 이 판결의 핵심입니다.
즉 학습이라는 '목적'이 정당해도, 데이터를 구한 '방법'은 따로 따진다는 것입니다.
[2] Bartz v. Anthropic — 미국 캘리포니아북부지방법원, 2025년 6월 판결(윌리엄 앨섭 판사). 적법하게 취득한 도서를 이용한 LLM 학습 및 구매 도서의 디지털 전환은 공정이용에 해당하나, 불법 복제물 사이트에서 내려받아 보관한 행위는 공정이용에 해당하지 않는다고 판단했다.
공정이용이 불인정된 세 번째 부분은 결국 배심 재판에 회부됐습니다. 미국 저작권법상 법정손해배상은 저작물 한 건당 최대 15만 달러까지 가능합니다. 700만 권이 걸린 상황이라면 산술적으로 회사의 존립이 흔들리는 규모가 됩니다. 결국 앤트로픽은 15억 달러에 합의했고, 이 합의는 지난 7월 20일 최종 승인됐습니다[3]. 법원은 이를 역사상 최대 규모의 저작권 집단소송 합의라고 표현했습니다.
[3] 바츠 사건 합의 — 2026년 7월 20일 최종 승인. 총 15억 달러 규모이며 약 48만 2천 종의 저작물이 대상이다.
한편, 재판에서 작가들은 이렇게 학습한 클로드가 자신들과 비슷한 책을 써낼 수 있게 되어 결국 자기 작품의 시장을 잠식한다고도 주장했습니다. 앨섭 판사는 시장 침해 우려에 대한 이 주장을 물리쳤습니다. 그는 학습의 변형성을 설명하면서, 작가들의 주장은 결국 아이들에게 글쓰기를 잘 가르치면 경쟁 작품이 쏟아진다고 불평하는 것과 다르지 않다고 했습니다. 저작권법이 보호하는 것은 특정 표현이지 그와 경쟁할 새로운 작품이 나오지 않을 권리는 아니라는 취지입니다.
📘 세 번째 — 캐드리 v. 메타[4]: 이겼지만 이긴 게 아닌
이 사건은 사라 실버만 등 작가 13명이 메타를 상대로 낸 소송입니다. 결과만 보면 메타의 승리인데, 이 사건은 판결문을 자세히 읽어볼 필요가 있습니다.
판결문에서, 차브리아 판사는 '시장 희석(market dilution)'이라는 이론을 강하게 인정했습니다. 생성형 AI가 유사한 작품을 시장에 무한정 쏟아내면 원작의 수요와 창작 유인 자체가 무너진다는 논리인데, 그는 이것이 입증되면 원고가 공정이용의 네 번째 요소(시장 영향)를, 나아가 공정이용 다툼 전체를 이길 수 있을 것이라고까지 했습니다. 앨섭 판사의 '아이들에게 글쓰기를 가르치는 것'이라는 비유에 대해서도 적절하지 않다고 정면으로 반박했고요.
그런데 정작 원고 13명이 시장 희석에 대한 증거를 하나도 제출하지 않았습니다. 메타는 자사의 학습이 원고들의 책 판매에 영향을 주지 않았다는 자료를 냈는데, 원고 측은 반대 증거를 내지도, 이 쟁점을 제대로 다투지도 않아, 차브리아 판사는 메타의 손을 들어줄 수밖에 없었습니다. 다만 그는 판결문에 "판결은 메타의 사용이 적법하다는 뜻이 아니라, 이 원고들이 잘못된 주장을 했고 옳은 주장을 뒷받침할 기록을 만들지 못했다는 뜻일 뿐"이라는 점을 명확히 작성하였습니다.
[4] Kadrey v. Meta — 미국 캘리포니아북부지방법원, 2025년 6월 판결(빈스 차브리아 판사). 라마(Llama) 학습에 대해 공정이용을 인정했으나, 이는 원고들이 시장 희석에 관한 증거를 제출하지 못한 데 따른 결론임을 명시했다. 토렌트로 내려받는 과정에서 이뤄진 배포(seeding) 관련 청구는 별도로 진행 중이다.
두 번째 사건과 비교하면, 같은 법원에서 이틀 간격으로 나온 두 사건이 정반대의 논리를 택한 셈입니다. 미국 안에서도 아직 답이 하나로 모이지 않았다는 뜻이죠.
🧭 마무리
세 사건을 토대로 미국의 스탠스를 정리하자면 다음과 같습니다:
그리고 시장 희석 이론을 처음으로 증명할 원고가 될 것으로 주목받고 있는 사건이 있습니다. 뉴욕타임스가 OpenAI를 상대로 낸 소송[5]에서, 지난 1월 법원은 OpenAI에 익명화된 챗GPT 대화 로그 2천만 건 전체를 제출하라고 명령했습니다. 만약 그 과정에서 시장 침해의 정황(예를 들어, 챗GPT가 유료 기사를 대체하는 콘텐츠를 일상적으로 생성해 온 것 등)이 드러난다면, 메타 사건에서 작가들이 해내지 못했던 '시장 침해의 증명'이 처음으로 이뤄질 수도 있을 것으로 보입니다.
[5] The New York Times Co. v. Microsoft Corp. & OpenAI — 미국 뉴욕남부지방법원, 사건번호 1:23-cv-11195(시드니 스타인 판사). 2023년 12월 제소됐고, 2025년 4월 법원은 OpenAI의 각하 신청을 대부분 기각하면서 AI 학습이 본질적으로 변형적이라는 주장을 배척하고 공정이용 여부는 사실심리를 거쳐야 한다고 보았다. 이후 다른 언론사·작가들의 유사 소송과 함께 다지구 병합소송(MDL No. 3143)으로 묶여 같은 재판부에서 심리 중이다. 2026년 8월 현재 증거개시 단계로, 재판 기일은 정해지지 않았다.
두 편에 걸쳐 살펴본 두 대륙의 답은 이렇게 갈립니다. 독일은 '(필수적인 범위를 벗어나는) 복제를 수반하는 학습은 라이선스가 필요하다'고 했고, 미국은 '학습은 변형적이므로 공정이용'이라 하면서 다만 취득 경로와 시장 영향을 단서로 남겼습니다.
그렇다면 한국은 어떤 방향으로 가게 될까요? 어느 쪽 질문을 더 중요하게 삼을 것인지(저작물이 모델 안에 어떤 형태로 남아 있는가? or 그 이용이 변형적인지/시장에 어떤 영향을 주는가?)에 따라, 같은 사안을 두고도 결론이 꽤 달라질 것입니다. 현재 TDM 면책 도입 논의가 진행 중이니 그 과정에서 윤곽이 잡힐 것으로 보입니다.
#기술과제도사이 #AI저작권 #공정이용 #FairUse #앤트로픽 #TDM #생성형AI